
SnapSharp 提供基于本地 LaTeX-OCR 的公式识别。下载对应模型后,选择单个公式图片即可生成 LaTeX,复制结果或导出 .tex 文件;使用前需要核对符号与结构。
下载模型,准备清晰截图
在“设置 → OCR 与识别 → 本地表格与公式”配置公式识别模型,下载完成后保存设置。模型准备好后,公式识别可在本机完成。
建议一次框选单个公式,保留上下标、分式横线和完整括号,尽量排除正文、页码与相邻公式。
从公式截图到 LaTeX
- 截图或复制需要处理的单个公式图片。
- 打开识别窗口,切换到“公式(本地 LaTeX)”模式。
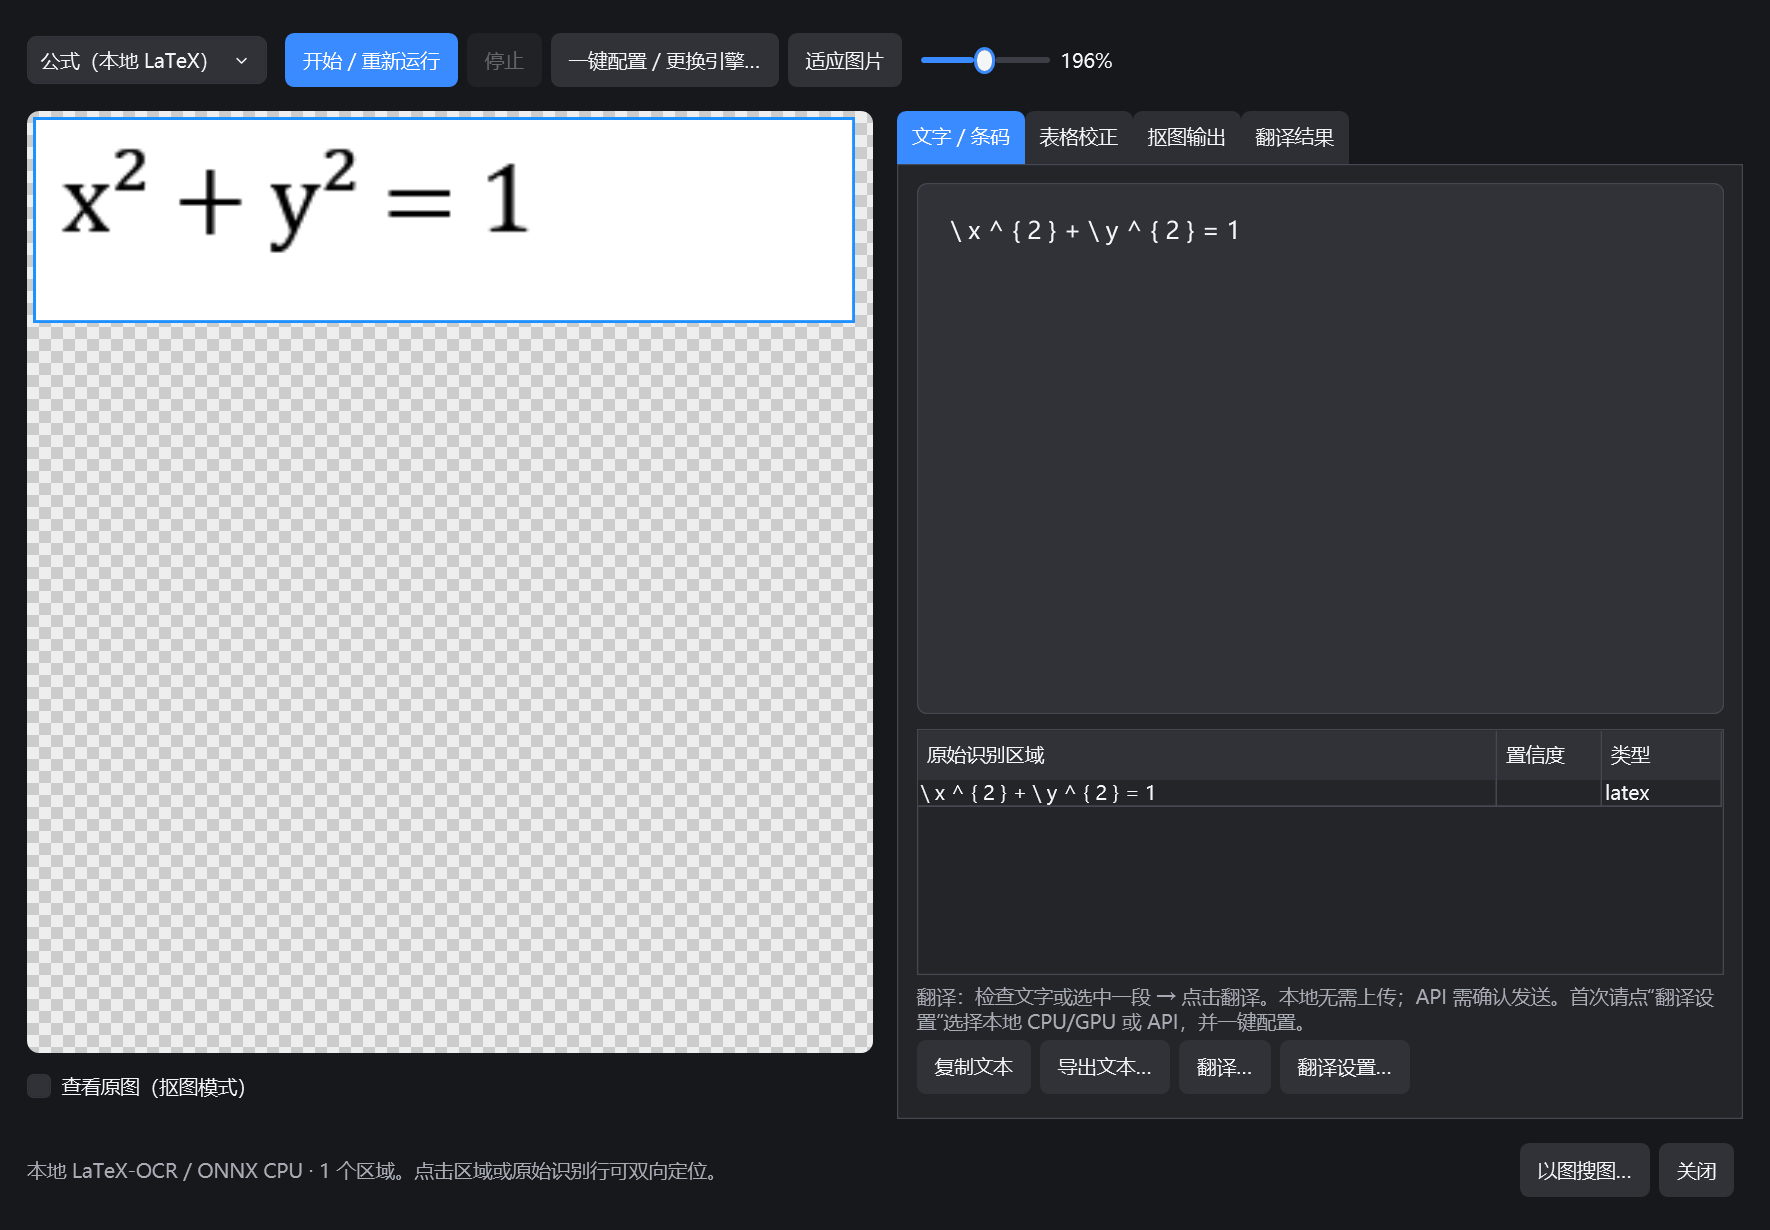
- 运行识别,对照原图检查返回的 LaTeX。
- 复制结果或导出 .tex,在自己的 LaTeX 编辑器中渲染并核对。
把结果渲染一次,再使用
重点检查上下标、分式、根号、括号范围和相似字符。例如数字 1、字母 l 和大写 I 可能混淆。模型输出的空格或间距命令不一定与原稿一致。
这项功能用于公式图片识别,不代表能够恢复整篇论文的版式或保证复杂手写公式识别。请以自己的样本测试效果。
示例:圆的方程
本页示例是在 CPU 上通过本地模型识别 x² + y² = 1 得到的实际结果。截图保留了模型输出的空格和 LaTeX 间距命令,未手工美化为标准答案。
更多操作、模型选择与故障处理,请查看 完整使用指南。