
SnapSharp 可以使用本地 SLANet 表格结构识别与 OCR,把表格图片转换为可检查的行列和单元格内容,再导出 XLSX 或 CSV。识别完成后需要核对结构与数值。
先配置表格与 OCR 模型
在“设置 → OCR 与识别”完成 OCR 配置,再到本地表格与公式区域下载表格模型并保存设置。首次下载需要联网,之后本地表格识别不上传图片。
使用尽量清晰、边界完整的表格截图,避免裁掉行列标题。若图片中混有大量段落,先裁出表格区域。
从表格图片到 XLSX
- 复制表格图片,打开托盘中的“识别粘贴板图片…”;也可从截图选区进入识别。
- 切换到表格模式,使用已配置的本地表格模型运行识别。
- 检查结果中的行、列、跨行、跨列与单元格文字,必要时手动修正。
- 导出为 XLSX 或 CSV,打开文件继续编辑,并再次核对关键数字。
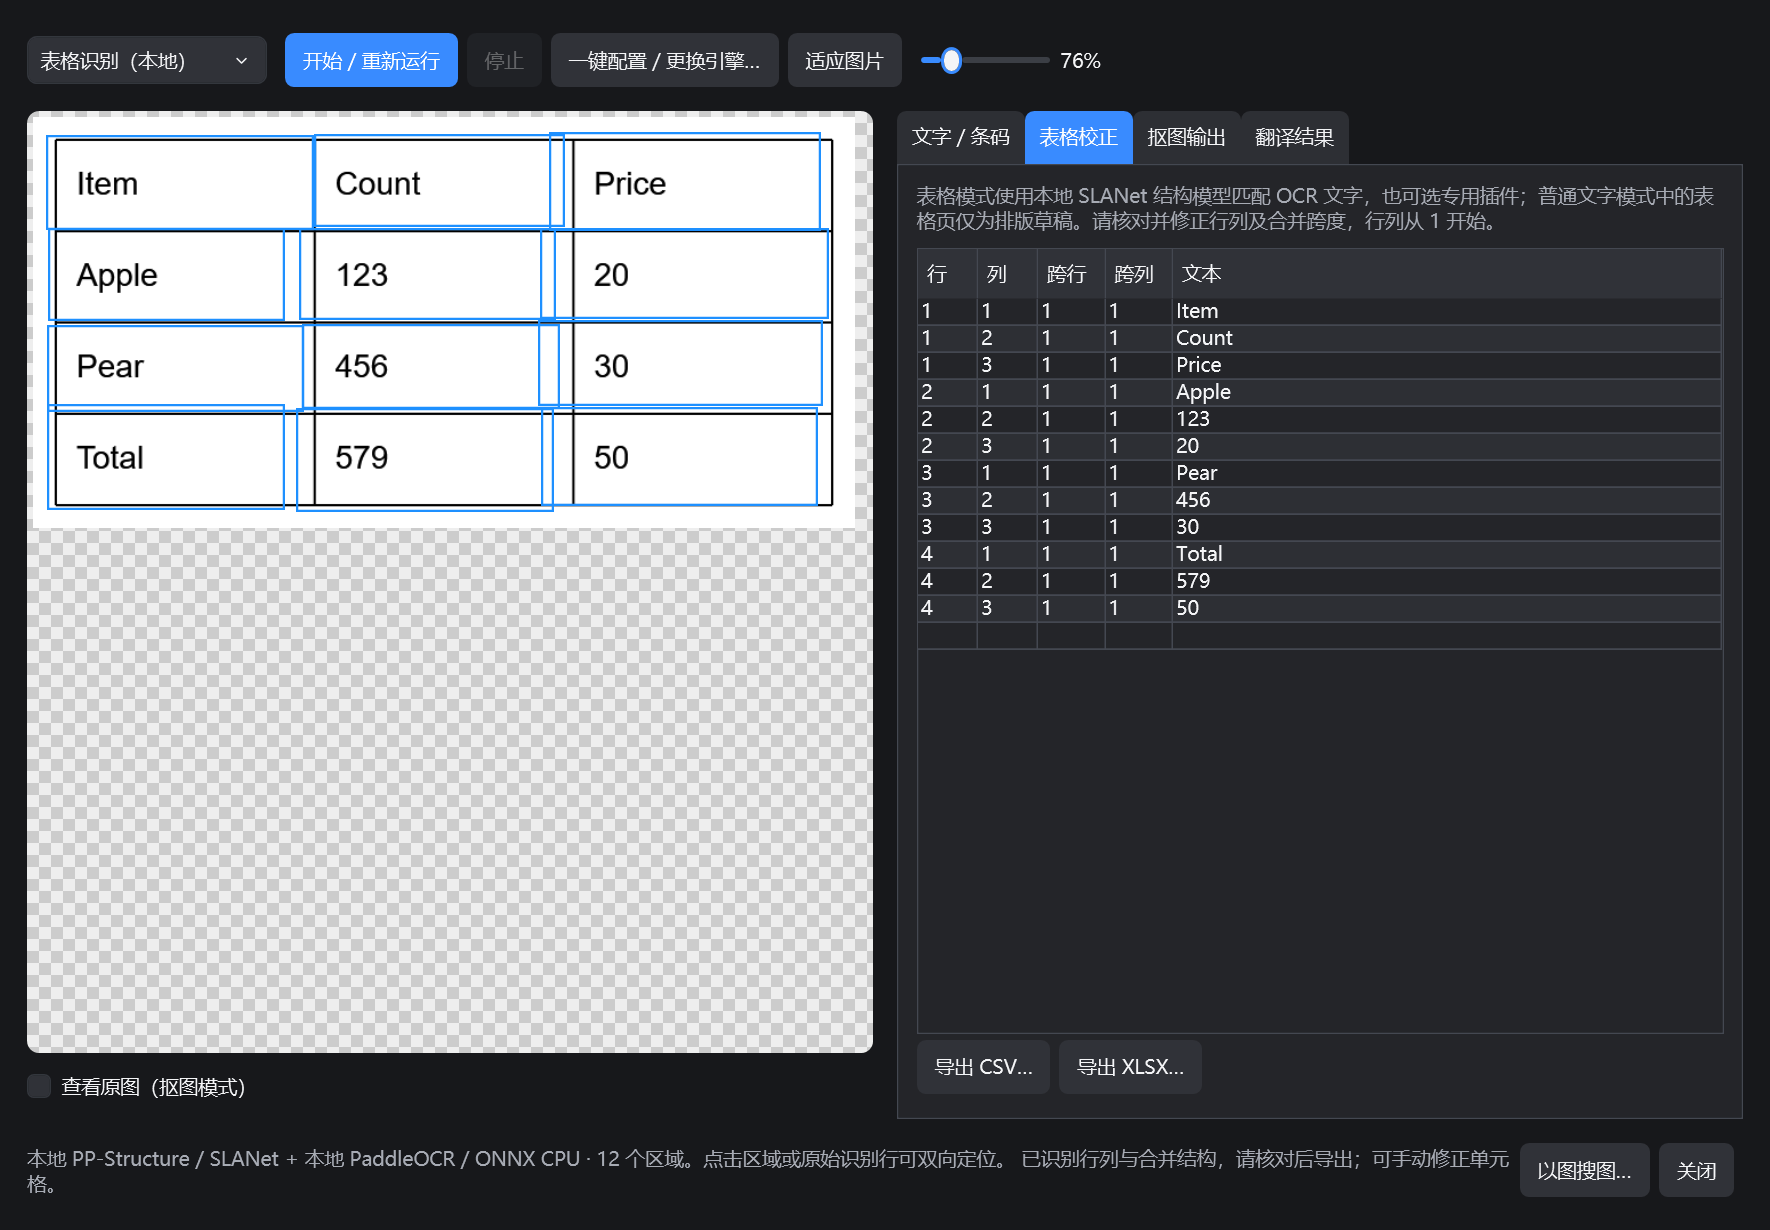
数值与结构都要核对
先看行列是否对应,再检查表头、合并单元格、小数点、负号、千位分隔符和单位。识别出来的空白与 0 也需要区分。
截图只包含可见内容,无法恢复原 Excel 的公式、宏、隐藏工作表或原始工作簿逻辑。导出的是图片识别得到的数据与结构。
这个示例说明了什么
本页使用软件固定版本的 SLANet 和 PaddleOCR,在 CPU 上识别一张自制表格,得到 4 行 × 3 列、共 12 个单元格。这是一个具体样例,不是所有表格的准确率承诺。
更多操作、模型选择与故障处理,请查看 完整使用指南。