
SnapSharp 提供本地 OCR:配置好相应引擎和模型后,可以在 Windows 电脑上识别图片中的中英文文字,无需上传图片。第一次下载模型需要联网。
先准备什么
准备 Windows 10 2004+ 或 Windows 11 x64 电脑,以及完整解压的 SnapSharp 发布包。先启动软件,在任务栏托盘打开设置。
到“设置 → OCR 与识别”,选择一键配置推荐 ONNX OCR,完成后保存设置。推荐中英文模型约 14.2 MB;这是 OCR 模型的下载量,不是整个软件的体积。
从图片提取文字
- 复制一张图片到剪贴板;也可以先按 Ctrl + Shift + A 截取需要的内容。
- 在托盘菜单打开“识别粘贴板图片…”,选择文字 OCR 模式和本地引擎。截图选区、贴图和编辑器也提供识别入口。
- 运行识别,对照左侧图片区域与右侧文本。点击区域或原始识别行可以互相定位。
- 检查内容后复制或导出文本。如需翻译,再单独配置本地翻译模型。
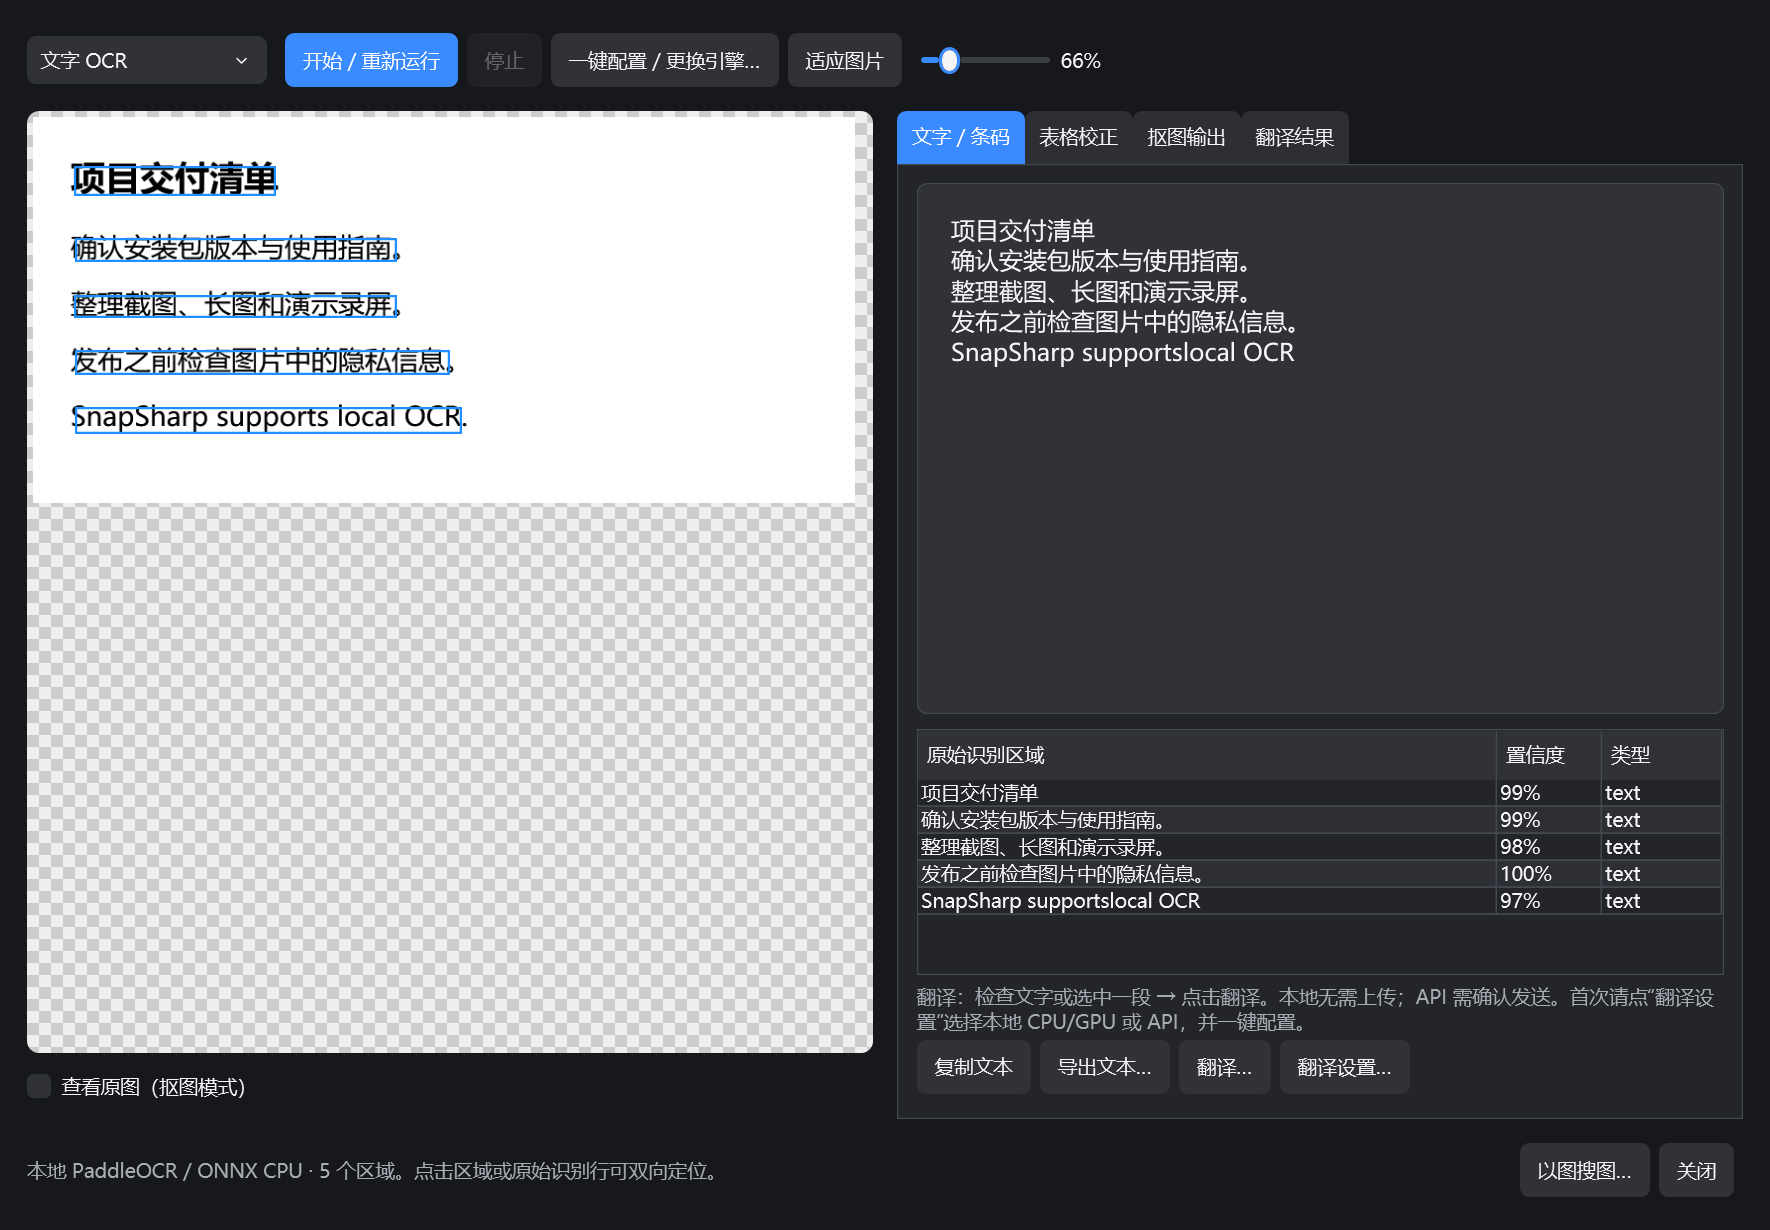
识别后,重点检查这些地方
优先使用清晰、文字较大的原图。空格、标点、混合中英文、数字和复杂排版都可能出现误识别;不要把识别结果直接当作原文。
本页示例保留了真实模型输出中的空格与文字错误,未用手工文本替换。处理速度和效果取决于输入、模型与硬件。
离线与隐私边界
本地 OCR 不需要上传图片或文字,模型与运行组件准备好后可以离线识别。可选的在线翻译与以图搜图属于其他网络服务,需要按提示启用或确认。
截图历史是本地保存功能,不等于加密存储。处理敏感资料时,也应留意保存目录与历史设置。
更多操作、模型选择与故障处理,请查看 完整使用指南。